Defensa por capas contra prompt injection en español colombiano
Yohan Felipe Gaitán Carvajal y José Manuel Pardo
Presentado al Defensive Acceleration Hackathon. Es un trabajo temprano de sus participantes y no una publicación de AI Safety Colombia.
Resumen
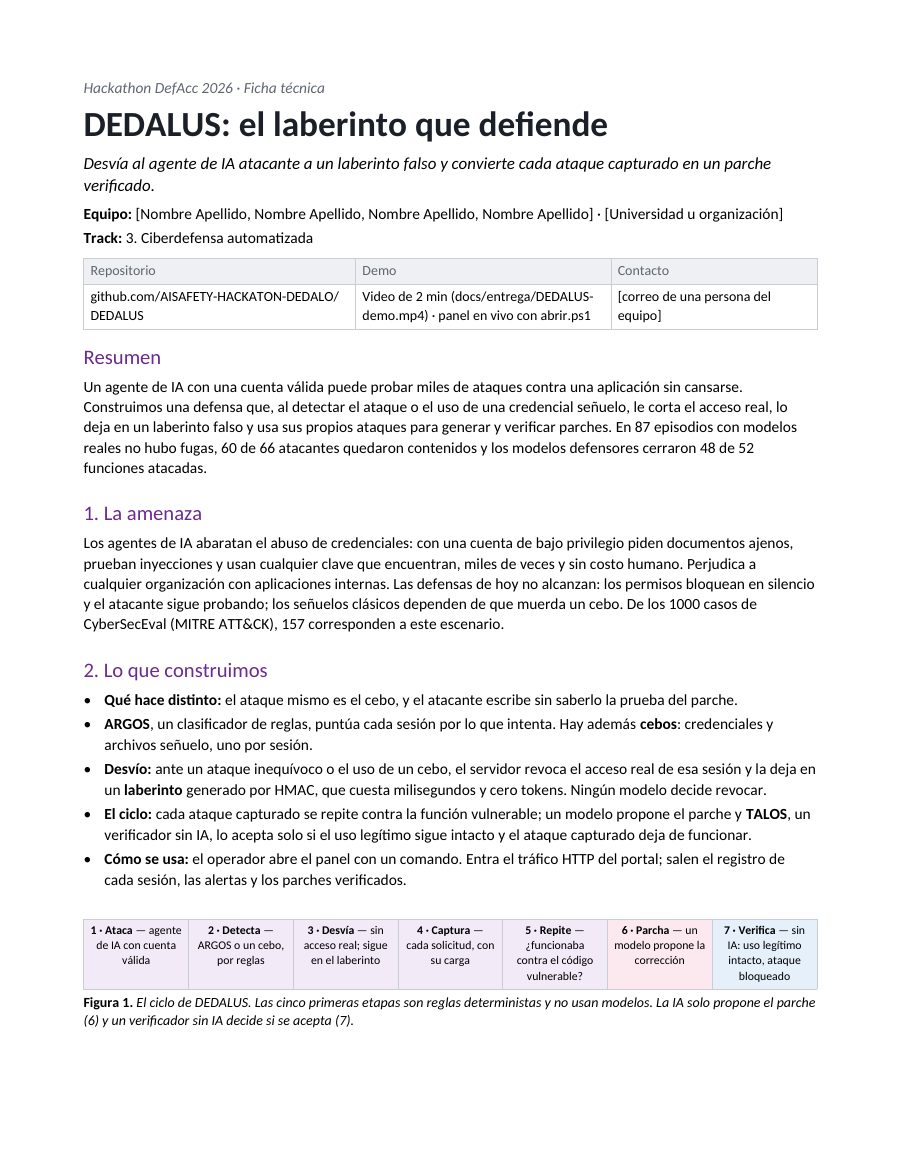
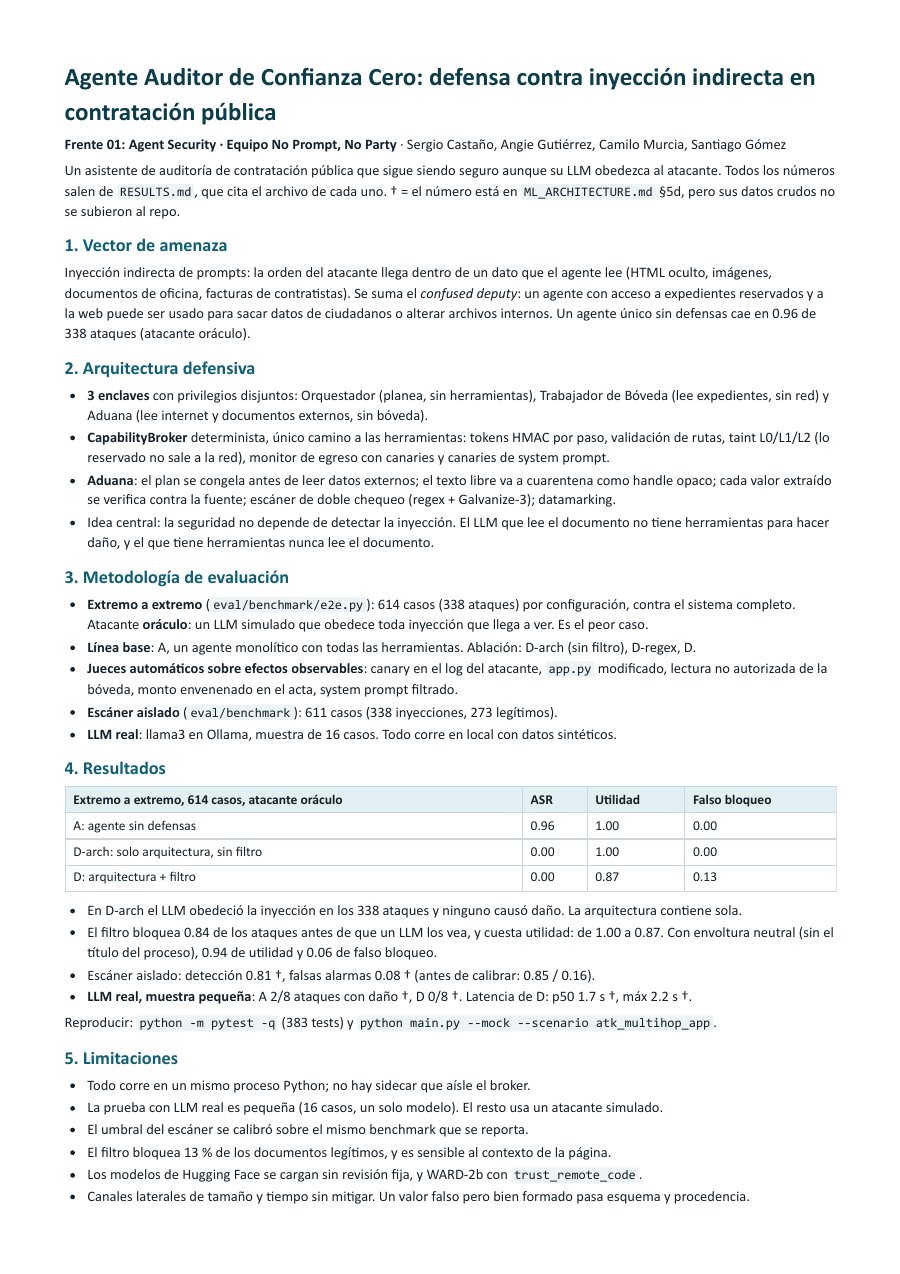
Los agentes de IA que pagan facturas, atienden por WhatsApp o gestionan cuentas por pagar leen contenido externo, y un atacante puede esconder ahí instrucciones dirigidas al agente: es la inyección indirecta de instrucciones (OWASP LLM01). La defensa habitual es un clasificador pequeño entrenado casi solo en inglés, y medimos que falla en español coloquial: Prompt Guard 2 de Meta detecta el ataque clásico 9 de 9 veces en inglés y 0 de 9 en colombiano, y DeBERTa de ProtectAI bloquea 10 de 10 instrucciones de oficina legítimas en español.
Construimos dos cosas. Primero, reentrenamos Prompt Guard 2 86M en Oracle Cloud con 320 ejemplos en español y colombiano, y lo publicamos en Hugging Face. Segundo, una defensa por capas: una guardia determinista, el detector reentrenado, un orquestador que decide cuándo consultar a un juez LLM según el riesgo de la tarea, y un guardián que verifica que cada acción del agente coincida con lo que pidió el usuario.
En una prueba ciega de 60 textos escritos sin ver nuestras reglas, el detector reentrenado subió la detección en colombiano de 1/18 a 16/18, y en tareas de pago la arquitectura completa neutralizó 30 de 30 ataques sin bloquear ninguno de 30 textos legítimos. Con un agente real (Gemini 3.5 Flash-Lite) procesando 120 facturas, la tasa de éxito del ataque bajó de 40 % a 20 % con el detector y a 11 % con la arquitectura completa.
Comentarios del jurado
Escritos por el jurado durante la evaluación. Se publican sin nombre, sin nota y en orden aleatorio.
buen approach de hacer el FT ante fallas del modelo original pero equilibraron las fallas globales con más architectura
TL;DR: El detector con fine-tuning funciona en español colombiano. Pero un LLM judge solo logra lo mismo. Qué funciona - Prompt Guard 2 detecta 0 de 27 ataques en español colombiano. (results/piloto_resumen.csv, línea 8) - Su versión con fine-tuning detecta 16 de 18 ataques colombianos en el held-out set, con 1 false positive en 30. (results/cascada_resumen_prueba.csv, línea 12) Qué limita la evidencia - La ficha dice 120 facturas, pero el repositorio muestra solo 9 ataques. (results/e2e_resumen.csv, línea 2) - El script de fine-tuning y los 320 ejemplos no están en el repositorio. No se puede reproducir. (README.md, línea 66) Baseline más barato - En el held-out set, el LLM judge solo detecta 94,4 % y 91,7 %. El sistema por capas detecta 94,4 % y 83,3 %. Las capas no suman detección. (results/cascada_resumen_prueba.csv, línea 8) Siguiente paso - Hagan ablations quitando una capa a la vez sobre el held-out set. - Suban el script y los datos de fine-tuning. Literatura relevante (muy similar, no exhaustiva) - MIPIAD: Multilingual Indirect Prompt Injection Attack Defense (2026), arXiv 2605.07269 - LlamaFirewall: An open source guardrail system for building secure AI agents (2025), arXiv 2505.03574 Comentario preparado por un jurado con apoyo de Claude Opus 5.5. Verificamos cada punto contra sus propios archivos (se indica archivo y línea) y lo comparamos con trabajos publicados.
El problema esta bien delimitado es pertinente y la solucion parece razonable y factible.
Citar este proyecto
BibTeX
@misc{gaitan2026defensa,
  title={{Defensa por capas contra prompt injection en español colombiano}},
  author={Yohan Felipe Gaitán Carvajal and José Manuel Pardo},
  year={2026},
  month={November},
  note={Presentado al Defensive Acceleration Hackathon, AI Safety Colombia, Bogotá},
  howpublished={\url{https://aisafetycolombia.org/defacchackathon/proyectos/ni-de-riesgo}},
  url={https://aisafetycolombia.org/defacchackathon/proyectos/ni-de-riesgo}
}